Razmah čipov za umetno inteligenco
Ameriški tehnološki velikani kot po tekočem traku napovedujejo lastne različice strežniških procesorjev za pospeševanje strojnega učenja. Razlogi za to so večplastni, med pomembnejšimi pa je osamosvajanje od Nvidie.
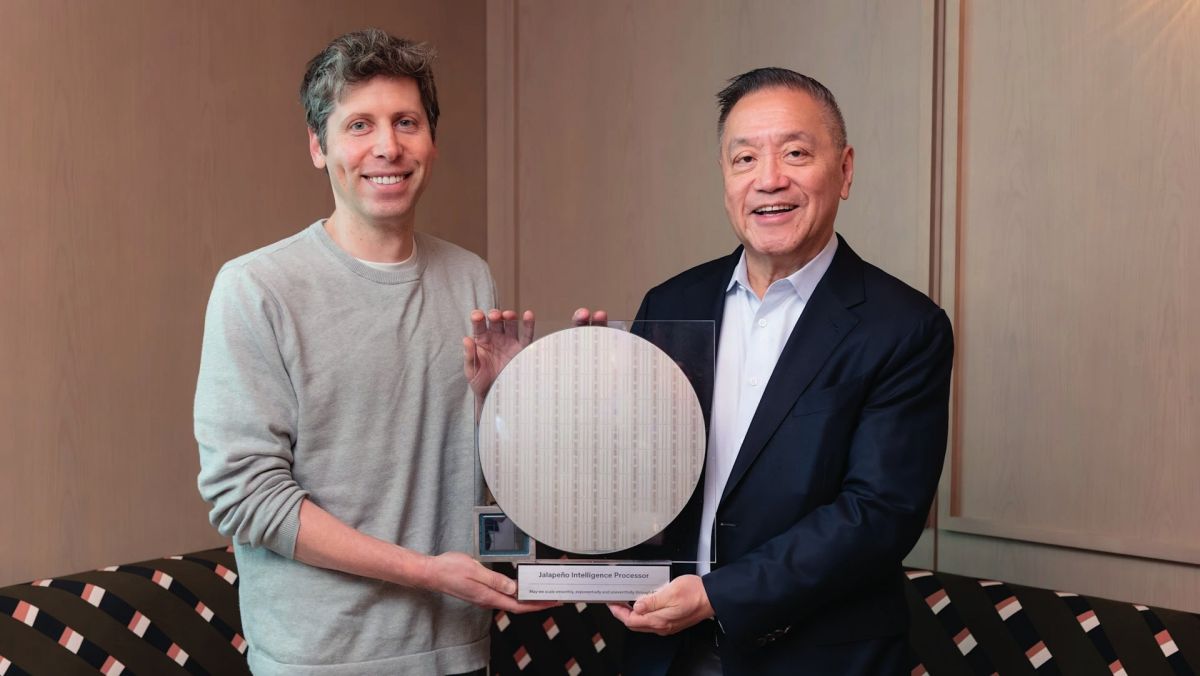
Direktorja OpenAI in Broadcoma, Sam Altman in Hock Tan, z rezino čipov Jalapeño med junijsko najavo. V OpenAI trdijo, da so »z umetno inteligenco čas razvoja skrčili na vsega devet mesecev«. To naj bi bilo obdobje med februarjem in novembrom lani oziroma med fazama RTL (Register-Transfer Level – abstrakcija podatkovne logike) in tapeout, pošiljanjem zasnove proizvajalcu. Ker ne poznamo globljih podrobnosti, je težko reči, kako drastično je UI zares pomagala.
Konec junija sta OpenAI in Broadcom naznanila čip, o katerem se je šušljalo že dlje časa. Jalapeño je inferenčni procesor, se pravi za pospeševanje izvajanja algoritmov umetne inteligence (UI) v oblaku, s katerim se nameravajo pri eni najbolj razvpitih informacijskih družb ta hip vsaj delno osvoboditi utesnjujoče navezave na Nvidijine izdelke. Razvoj so začeli jeseni leta 2024, prvo vezje so imeli v rokah letošnjega maja. O tehničnih podrobnostih sami niso bili preveč zgovorni, zato pa so avgusta na obisk povabili paradni industrijski medij SemiAnalysis, da je prototipni model na hitro preizkusil. Rezultate je sicer še vedno treba jemati z zrnom soli, toda po tem preizkusu sodeč gre za resnično zmogljiv čip, ki obenem ni ozko optimiziran zgolj za algoritme tega podjetja, temveč gre za univerzalno močan inferenčni primerek. SemiAnalysis so v svoji običajni vehementni maniri dejali kar, da se lahko Nvidii (vsaj malo) tresejo hlače.
Čipi za Facebookov zid
Pri Meti se strežniške strojne rešitve nahajajo pod krovno oznako MTIA za Meta Training and Inference Accelerator. Prvi dve generaciji, MTIA 100 iz leta 2023 in MTIA 200 iz lanskega leta, sta bili očitno prvenstveno pilotni. Naslednje štiri različice naj bi bili aktualni in prihajajoči pospeševalniki za različne naloge. MTIA 300 služi algoritmom za serviranje vsebin na Facebooku ter Instagra-mu. MTIA 400, 450 in 500 pa so namenjeni predvsem izvajanju generativne umetne inteligence. Kateri od zadnjih dveh, ki bosta prispela zgodaj prihodnje leto, je Iris, še ni povsem jasno. Metina linija pa je od vseh trenutno videti najbolj osredotočena in konservativna: primerki so usmerjeni v izvajanje in se še najbolj razlikujejo v količinah pomnilnika.
To je samo najodmevnejša v vrsti podobnih najav. Microsoft se v času pisanja teh vrstic pripravlja na uradno napoved podobnega procesorja Maia 300. Septembra naj bi po poročanju Reutersa pognali tudi proizvodnjo sorodnih Metinih čipov Iris. O vseh novih modelih Googlove linije TPU se sploh ne piše več posebej, ker so postali samoumevni, podobno velja za Amazonove gravitone in trainiume. O lastni tovrstni strojni opremi intenzivno razmišljajo celo pri Anthropicu, kjer trenutno še sestavljajo razvojno ekipo, potem ko naj bi poleti padel v vodo nakup podjetja MatX. Pod črto želijo očitno vsi ameriški oblačni velikani za umetno inteligenco pridobiti strojne vire lastnega porekla. Ker se stroški razvoja takšnih čipov začnejo pri okvirno 500 milijonih evrov in se hitro povzpnejo na milijardo ali dve ter obenem zahtevajo dolgoročno, vztrajno pozornost, morajo biti motivi zanje tehtni. Med njimi resda najdemo tudi sledove geopolitičnih trenj, ki so trenutno tako zelo popularna, toda kot bomo videli, je poglavitno gonilo še vedno – denar.
Draga znamka
Nvidia v zadnjih dveh letih slovi kot podjetje z najvišjo tržno vrednostjo na svetu, kar je praktično v celoti mogoče pripisati snovanju procesorjev za umetno inteligenco. Brez njihovih čipov, kot sta H100 in B200, se ne razvije noben velik komercialni jezikovni ali generativni model. O tem govori Nvidijin tržni delež, ki se pri procesorjih za umetno inteligenco v oblaku giblje med 75 in 80 odstotki; natančnih številk nimamo, ker je podjetje notorično stiskaško s podatki, koliko naprav je prodalo, komu in po kakšni ceni. Povpraševanje po njihovih platformah je tolikšno, da se čakalna doba za najmodernejše primerke v zadnjih letih giblje okoli 8–16 mesecev, odvisno od tega, koliko pogajalske teže ima stranka in za kateri izdelek natančno gre.
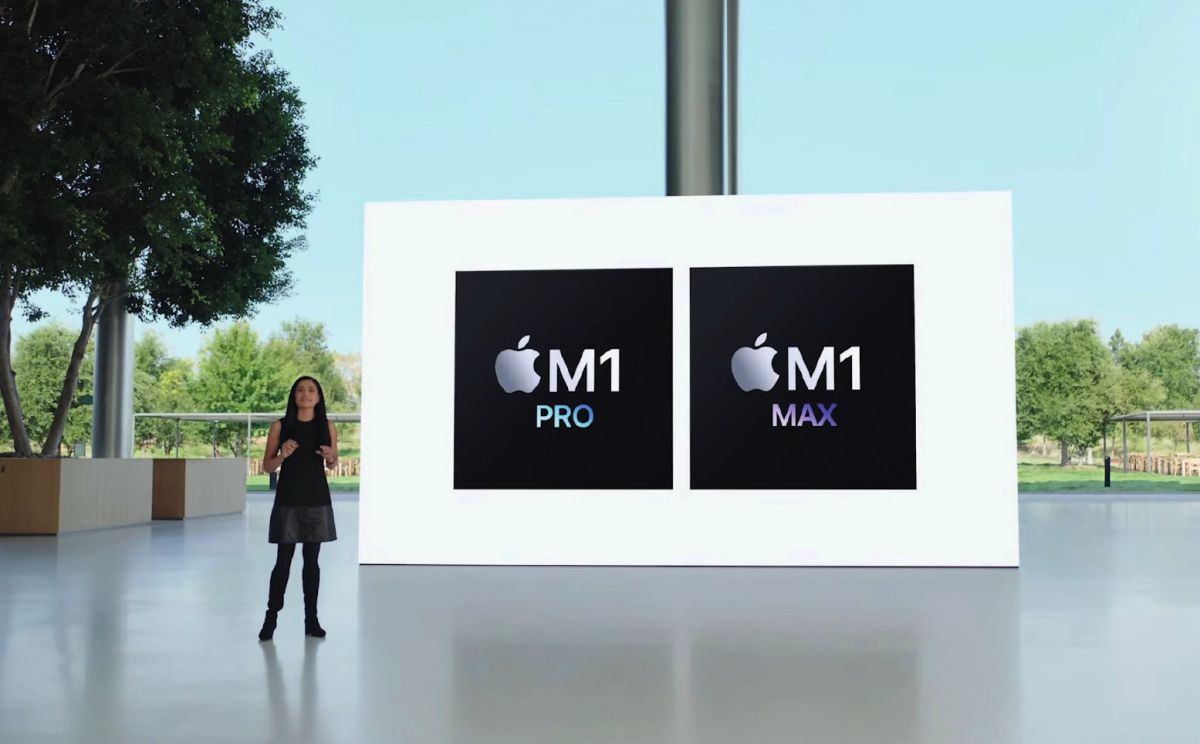
Kdor je ob domorodnih čipih pomislil na Applovo družino M, se ni uštel, saj gre za podobno dinamiko: podjetja se želijo rešiti odvisnosti od časovnic, oblikovalskih odločitev in napak zunanjega proizvajalca.
To se neposredno prelije v marže, ki pri trenutno aktualnih modelih generacije Blackwell sežejo čez 80 odstotkov: medtem ko znaša proizvodna cena procesorja B200 nekaj čez 6.500 ameriških dolarjev, ga prodajajo za ceno 30–40 tisočakov. To pomeni, da štiri petine zneska za Nvidio predstavlja dobiček (ki se v nemajhnem delu nato prelije v razvoj, s čimer podjetje ohranja tehnološko prednost). Navdušenje nad umetno inteligenco je osrečilo vse proizvajalce strojne opreme, a vendarle je zeleni tabor pri procesorjih zaradi vodilnega mesta v zaznavni prednosti. Pri AMD morajo kot drugouvrščeni, ki si trenutno prizadevajo predvsem povečati približno petodstotni tržni delež, igrati tudi cenovno bitko. Marže njihovih zmogljivih modelov so zato zgolj okrog 45 odstotkov, nižje kot tiste iz celotnega poslovanja družbe. To se pravi, da Nvidia svoje tehnološko prvenstvo dejansko prodaja s sila zasoljenimi vrednostmi.
Zamudniki iz Redmonda
Med veliko trojico strežniških velikanov se je Microsoft pri lastnih čipih za oblak zares obiral, pa čeprav ima skozi konzole Xbox že dolgo prakso sodelovanja pri razvoju prirejenih oblik procesorjev. Vse kaže, da je vodilne v Redmondu k ukrepanju spodbudilo šele veliko nihanje v cenah in razpoložljivosti strojne opreme, ki ga je sprožila pandemija kovida. Lastne rešitve so najavili šele jeseni 2023, in sicer v obliki čipa za inferenco Azure Maia 100 ter centralnega strežniškega procesorja Azure Cobalt 100. Oba sta trenutno v drugi generaciji. Maia 200 je za strežniški tip čipa precej zajeten kos silicija, na papirju trikrat močnejši v režimu formata FP4 od Trainiuma3, kar pa nam v bistvu pove samo to, da so se v Microsoftu odločili za pristop gnetenja čim večje količine elementov na en čip, medtem ko v Amazonu zmogljivosti raje porazdelijo. V Redmondu Maio 200 prav tako označujejo za ‚inferenčno pošast‘, hkrati pa omenjajo, da procesor izkoriščajo tudi v nekaterih fazah učenja. To je postalo nekako značilno za novejše primerke takšnih naprav.
Zelenemu velikanu seveda takšno stanje zelo ustreza, kar lahko vidimo tudi iz dejstva, da se jim doslej ni čisto nič mudilo pri razvoju morebitnih cenejših ali varčnejših izpeljank. Nvidijini procesorji in platforme so (bili) praktično docela usmerjeni v surovo zmogljivost, tako v smislu gole hitrosti kot nabora funkcij. Takšni izdelki se najbolj odlikujejo pri tehnološko najzahtevnejših opravilih, kot so raziskave na čelu napredka, kjer najširši izbor funkcij inženirjem ponuja najpriročnejša orodja za tipanje v neznano ali ustvarjanje najzmogljivejših algoritmov. A za nekatere druge režime dela Nvidijini GPGPU niso optimalni. Če zgolj poganjamo funkcijsko zamejen generativni algoritem, ne potrebujemo vseh mogočih strojnih zmogljivosti, ki so potrebne za njegovo učenje; namesto tega sta mnogo pomembnejši varčnost delovanja in odzivnost, da uporabnik odgovore prejme čim prej. To je odprlo vrata tekmecem, da zapolnijo praznino, ki jo je Nvidia vse bolj očitno puščala v tem delu.
Trening in izvajanje
Da bi lahko razumeli, kako je mogoče napraviti varčnejši in preprostejši čip za poganjanje umetne inteligence, se moramo najprej pomuditi pri različnih fazah delovanja strojno učenih algoritmov. Kot pove že ime, je njihova bistvena razlika v primerjavi s klasičnim računalniškim programjem v tem, da jih je treba med njihovim razvojem uriti na zbirkah učnih podatkov. Strukturno namreč posnemajo centralno živčevje živih bitij, in sicer s programsko emulirano nevronsko mrežo, sestavljeno iz orjaškega spleta vozlišč in povezav med njimi. Uporabni podatki se v takšni nevronski mreži pretežno nahajajo v moči opisanih povezav – tako imenovanih ‚utežeh‘ (weights) oziroma ‚parametrih‘ algoritma. Te uteži se nastavlja med fazo treninga, ko se algoritem na vhodni strani ‚hrani‘ z učnimi podatki in nato prireja parametre, da dobimo na izhodni strani želeni rezultat. Popularen nazorni primer: če na vhodu vnesemo sliko psa, je treba uteži primerno nastaviti, preden bo izhod pravilno presodil, da gre za psa. Fazi uporabe algoritmov umetne inteligence po drugi plati pravimo izvajanje ali inferenca. Tam parametri ostanejo fiksni, saj jih dandanašnji še ne spreminjamo med samo rabo.
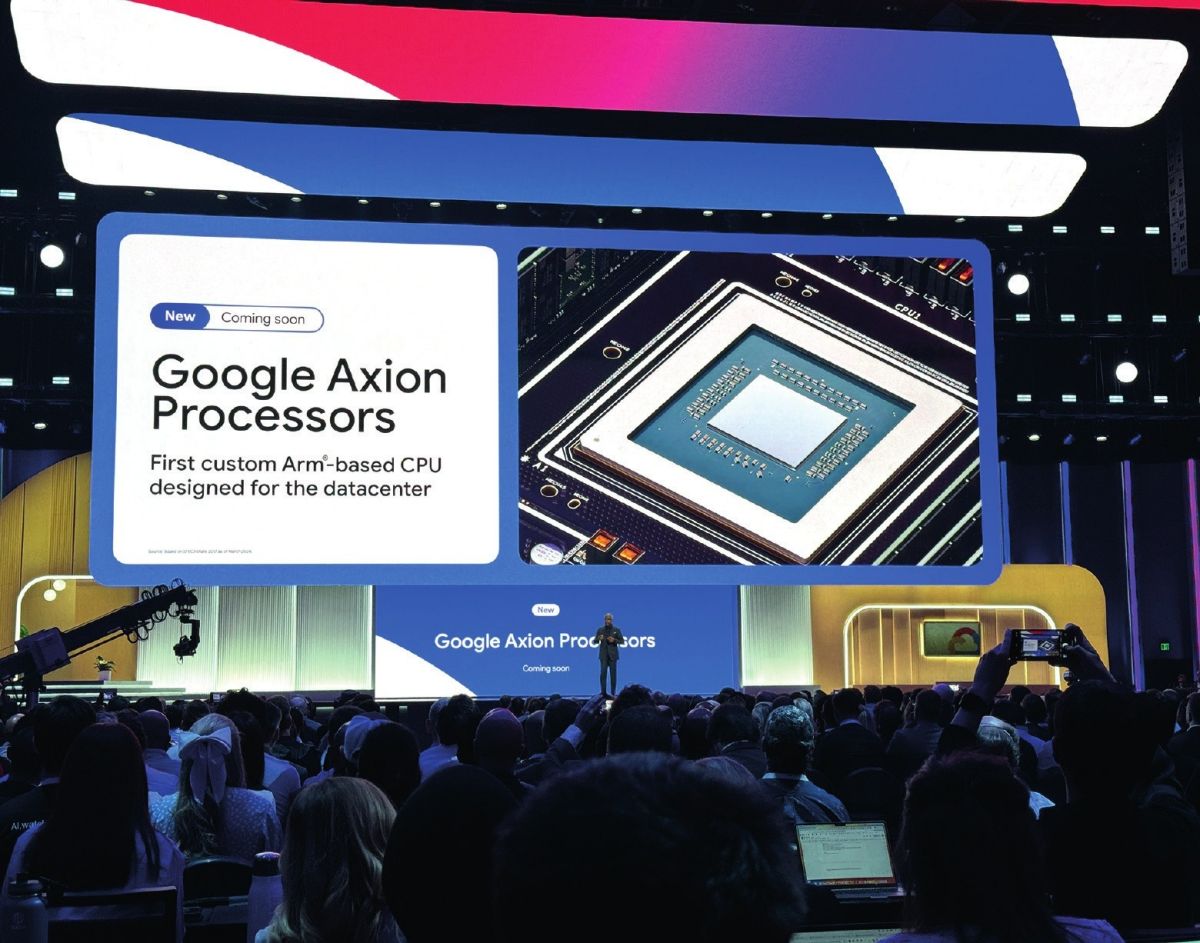
Pri centralnih strežniških procesorjih je položaj med Googlom in Amazonom obrnjen, saj je prvi šele pred dvema letoma najavil lastne, pod znamko Axion. Kot je za takšne čipe značilno, slonijo na Armovi tehnologiji Neoverse, ki so jo Britanci razvili z namenom prodora v podatkovne centre.
Fazi treninga in izvajanja imata zato različne strojne zahteve, ki izhajajo predvsem iz samih načinov, kako treningi danes potekajo. Če si vnovič izposodimo sliko psa, jo najprej uvozimo v nevronsko mrežo in pogledamo rezultat, ki prispe na izhod. Tega primerjamo z vhodnim podatkom in z matematičnimi orodji izračunamo funkcijo napake (loss function), se pravi, koliko se je algoritem zmotil. Nato poskušamo to napako zmanjševati na način, da potujemo od izhoda nazaj skozi mrežo z eno ključnih današnjih metod, imenovano backpropagation. Poenostavljeno povedano: računamo gradient funkcije napake in uteži spreminjamo na način, da jo čim bolj zmanjšamo. Če ima bralec vsaj nekaj znanja matematike, je iz opisa očitno, da pri takšnih postopkih uporabljamo kopico računskih orodij, od diferencialne analize dalje, zato potrebujemo zmogljive strojne računske enote, ki obvladajo širši nabor funkcij. Prav zato so čipi vrste GPGPU (general-purpose graphics processing unit), to se pravi nekdanji grafični procesorji, ki so se prelevili v obdelovalce splošnih računskih nalog, še vedno jedro strojnih učnih zmogljivosti. Ne glede na uvajanje lastnih različic strojne opreme vsi poglavitni skrbniki oblakov urjenje svojih jezikovnih modelov še vedno snujejo okoli Nvidijinih naprav.
Izvajanje ne potrebuje tako zmogljivih strojnih virov. Signal tu potuje skozi ‚izučeno‘ nevronsko mrežo glede na utežne jakosti povezav. To pomeni, da več kot devet desetin preračunavanja odpade na preprosto matrično aritmetiko oziroma množenje in seštevanje matrik. Tako je mogoče oblikovati računska vezja, ki so osrediščena okoli takšnih operacij, kar je bila premisa tako prvih Googlovih čipov vrste TPU kakor tudi enot NPU (neural processing unit), se pravi pospeševalnikov umetne inteligence v sistemskih čipih telefonov in prenosnih računalnikov. Takšni najpreprostejši pospeševalniki izvajanja so sestavljeni iz dveh glavnih segmentov: najprej vezja MAC (Multiply Accumulator Circuit), katerega edina naloga je, da zmnoži dve števili in rezultat prišteje v skupni register; in pa pomnilnika. Takšni namenski čipi (ASIC – application-specific integrated circuit) so zaradi osredotočenosti in enostavnosti bistveno varčnejši od generaliziranih procesorjev vrste GPGPU.
Prva ‚odpadnika‘
V Googlu so se zamisli o lastnih strežniških napravah resno lotili v začetku prejšnjega desetletja, se pravi mnogo pred aktualno norijo okrog generativnih modelov. Takrat smo pod ‚umetno inteligenco‘ pretežno razumeli napredno iskanje in pa tolmačenje slik, a že tedaj so v podjetju presodili, da bi s čipi vrste ASIC lahko bistveno prihranili v primerjavi s klasičnimi strežniškimi procesorji Intela, AMD in Nvidie. Leta 2013 so privabili Amirja Saleka, da je zagnal razvojni laboratorij Googlovih lastnih čipov za poganjanje oblaka. Spomladi leta 2016 so na konferenci Google I/O pokazali prvo generacijo procesorja TPU (Tensor Processing Unit) in pojasnili, da ga uporabljajo že kakšno leto, kar začetke samorodnega oblačnega procesorskega umetnointeligenčnega hardvera postavlja v leto 2015. Ime linije prvenstveno izhaja iz programske platforme Tensor-Flow, okoli katere je bila pravzaprav zasnovana. Najbolj poveden razlog za Googlovo pot na svoje je njihova inženirska ekipa leta 2017 objavila v članku In-Datacenter Performance Analysis of a Tensor Processing Unit, kjer med drugim navajajo, da naj bi »čipi TPU pri inferenci dosegli od 30-do 80-kratno večjo zmogljivost na vat v primerjavi z rabo klasičnih grafičnih ali centralnih procesorjev«.
Samosvoja zgodba so Kitajci, ki so se morali lastnih čipov hočeš nočeš lotiti zaradi ameriških sankcij za Nvidijine izdelke. Področje tam obvladujeta Baidu in Huawei, za katera večino izdelkov izdela SMIC.
Ni presenetljivo, da je bil drugi velikan, ki je ob podobnem času stopil na samostojno pot, Googlov največji tekmec v strežniških storitvah, Amazon. Januarja 2015 so kupili izraelsko podjetje za načrtovanje vezij Annapurna Labs, ki je hitro postalo ena najpomembnejših Amazonovih podružnic in ena bistvenih strank tajvanskega proizvajalca TSMC. Sodelovali so pravzaprav že pred tem, saj so v Annapurni zanje zasnovali omrežne čipe linije Nitro, ki jih še danes najdemo v vsaki strežniški rezini AWS in so namenjeni usmerjanju podatkov ter virtualizaciji. Nato so se lotili zahtevnejše naloge, splošnejšega strežniškega procesorja v Armovem ukaznem naboru, ki je dobil naziv Graviton. Ta je prispel leta 2018 in pomenil bistveno prelomnico, saj je šlo za poglavitno vstopnico Armovih arhitektur na strežniško področje, ki je bilo dotlej tradicionalno bojišče dvojca Intel-AMD. To pomeni, da so se v Amazonu pravzaprav najprej lotili osamosvajanja od omenjenih procesorskih velikanov, Nvidia pa je prišla na vrsto leto zatem. Takrat smo videli prvi primerek čipa Inferentia, namenjenega pospeševanju izvajanja umetne inteligence. Leta 2022 je spisek zaokrožil še zadnji čip družine, Trainium, ki je seveda namenjen urjenju.
Prihranjeni cekini
Glavna značilnost snovanja čipov, kot se ga lotevajo siceršnji strežniški velikani, je gotovo ta, da na lastne procesorje vselej gledajo v smislu celotne bilance podjetja, in to dolgoročno, ne pa v luči zmogljivostnih rekordov posameznega primerka. Ali kot navajajo v AWS: glavni cilj takšnega dizajna je brezkompromisno nižanje vseh stroškov (total cost of ownership), se pravi tako cene nakupa kot stroška delovanja v vsej življenjski dobi naprave. V tem članku zato ne bo množičnega navajanja številskih zmogljivosti posameznih čipov, saj so te manj pomembne. V AWS mirne duše povedo, da so posamezni trainiumi na papirju dvakrat slabši od Nvidijinih in Googlovih čipov, a jih lahko ob primerni ceni preprosto inštalirajo dvakrat več. Kako daleč gredo ta podjetja v opisani strategiji, ponazarja dejstvo, da modernejše izvedenke takšnih procesorjev podpirajo delovanje v različnih hladilnih režimih, tako zračnih kot tekočinskih ali potopnih. Katerega dejansko izberejo, je odvisno od konkretne stranke in lokacije podatkovnega centra. Z drugimi besedami: vse je podrejeno optimizaciji vertikalne integracije.
Amazonova oblačna hrbtenica
VAmazonovi strežniški izpostavi Amazon Web Services (AWS) imajo najdlje trajajoč in najbolj raznolik ekosistem lastnih strojnih zmogljivosti, saj so čipi Nitro še starejši od Googlovih TPU, medtem ko so Gravitoni najbolj razširjeni strežniški centralni procesorji, ki niso xeoni ali epyci. Na papirju je velikan v primerjavi z Googlom malce zamudil, ko gre za pospeševalnike umetne inteligence, a je zaostanek hitro izničil. Do zdaj smo videli tri generacije čipov Trainium, napovedana je že četrta. Inferentia je izšla v dveh različicah, zadnja leta 2023. Zelo zanimivo je, da tretje generacije še niso napovedali in se očitno usmerjajo v strategijo, da bodo tudi za izvajanje pretežno izkoriščali trainiume, ki bi s tem postali Amazonov univerzalni čip za UI. To bi bilo ravno nasprotno od tega, kar počne Google. Kot poudarjajo pri SemiAnalysis, je razlog za to predvsem čim gibkejša prilagodljivost posamezni stranki, seveda pa mora čip zaradi tega podpirati več zelo različnih režimov delovanja.
Sem in tja je na inženirskih srečanjih mogoče ujeti kakšno podrobnost o prihrankih in zmogljivostih. V AWS tako pravijo, da so s trainiumi dosegli »50 odstotkov večjo učinkovitost pri urjenju jezikovnih modelov v primerjavi z drugimi možnostmi«. Microsoft z Maio 200 »prihrani 30 odstotkov pri izvajanju Copilotovih algoritmov«. Natančne številke so poslovna skrivnost, toda glede na gibanja ni dvoma, da se gigantom ukvarjanje z lastnim silicijem očitno zelo izplača, saj dejavnost vsi izrazito širijo. Na tem mestu pa je treba poudariti, da je strojna oprema le polovica izziva. Eden glavnih razlogov za Nvidijino svetovno prevlado oziroma njeno vztrajnost je namreč programska platforma CUDA, ki jo v podjetju pozorno negujejo kot temeljno programje za razvoj umetne inteligence. To je v bistvu glavni razlog, da se lastnih strojnih rešitev lotevajo pretežno največja podjetja, ki imajo poleg finančnih sredstev na voljo tudi dovolj strokovnjakov za razvoj lastnega podpornega programja, brez katerega je osamosvajanje od Nvidie praktično nemogoče. V Googlu sta to JAX in TensorFlow, v AWS Neuron in tako naprej.
Nvidijin odgovor
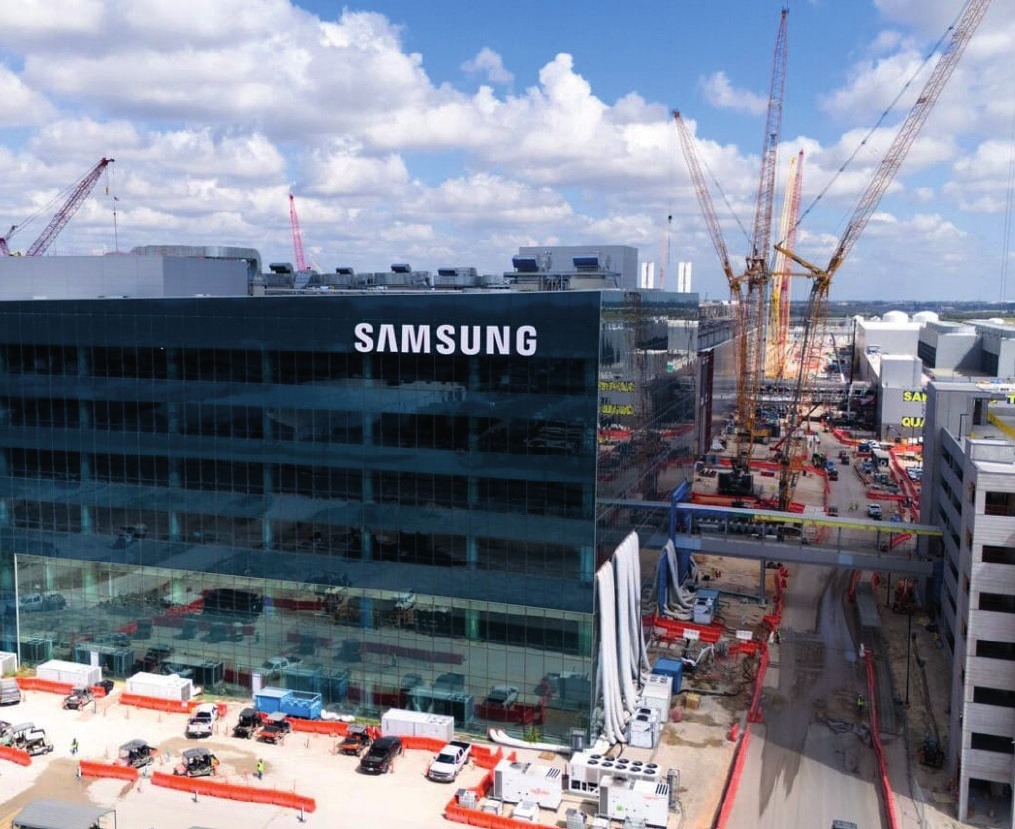
Če pri umetnointeligenčnih procesorjih vlada Nvidia, je med proizvajalci trenutno v premoči TSMC. Samsunga pri tovrstnih ameriških strežniških čipih praktično ni, se pa Korejci prebujajo in se menda o sodelovanju dogovarjajo z Anthropicom.
Po zapisanem je jasno, da morajo strežniška podjetja še vedno loviti prefinjeno ravnotežje med lastnimi zmogljivostmi in barantanjem z Nvidio, ko gre za najzmogljivejše čipe. Zeleni velikan si ob prvih generacijah Googlovih in Amazonovih rešitev ni delal skrbi, saj je povpraševanje po njihovih čipih še vedno precej večje od razpoložljivosti, prav tako ni v nevarnosti njihova surova tehnološka prednost. A to se spreminja, in sicer zaradi dvojega. Prvič, če so bili zgodnji primerki TPU pohlevne inferenčne naprave, pa zadnja leta takšni čipi prevzemajo tudi vse več bremena učenja generativnih modelov. Googlov in Amazonov oddelek sta že upihnila deseto svečko in imata dovolj izkušenj, da se lotevata tehnično vse bolj zahtevnih izzivov, kar se kaže v trainiumih in TPU 8t. In drugič, medtem ko so doslej oblačna podjetja takšne izdelke zadrževala za lastne podatkovne centre, pa smo nedavno lahko videli tudi prve tržne podvige. Tako Google kot AWS sta namreč svoje čipe prodala Anthropicu in Amazonov Andy Jassy se je na enem letošnjih posvetov z vlagatelji pohvalil, da je posel s prodajo takšnih zmogljivosti lani že znašal več milijard dolarjev.
Osem generacij Googlovih tenzorjev
Za čipe TPU je tudi laična javnost prvič slišala maja 2016, ko je Sundar Pichai razkril, da je algoritem AlphaGo, ko je dva meseca pred tem v odmevnem dvoboju v igri go premagal Leeja Sedola, tekel prav na teh napravah. Odtlej smo videli že šest posodobitev, trenutno pa čakamo na nastop osme generacije, ki naj bi sledila konec tega leta. Pogled na podrobnosti posameznih modelov čipov TPU razkriva nekatere temeljne premike, ki so značilni za industrijo. Najprej podatek, da so ob prehodu v drugo generacijo, leta 2017, s pomnilnika DDR SDRAM prešli na bolj prepustni HBM, in sicer zaradi dejstva, da je premlevanje nevronskih mrež v splošnem silno obremenjujoče za pomnilnik, ki mora hraniti vso goro parametrov algoritma. Najnovejši preskok nas čaka v osmi generaciji, ko bo velikan linijo razmejil na izvedenke za trening (8t) ter inferenco (8i).
Nvidijin odziv smo lahko opazili decembra lani, ko je z ameriškim zagonskim razvijalcem inferenčnih vezij Groqom sklenila odmeven posel z licenciranjem tehnologije, vreden 20 milijard dolarjev. Konkreten rezultat tega sodelovanja je sledil na avgustovski konferenci Hot Chips, ko je podjetje najavilo procesor Nvidia Groq 3 LPX, to je inferenčni čip, osredotočen na varčno in hitro (odzivno) izvajanje, s čimer gre za prvi takšen ASIC iz zelenega tabora. Zanimivost: podjetje Groq je ustanovil Jonathan Ross, eden od očetov Googlovih TPU. V podoben podvig se je podal tudi večni Nvidijin tekmec AMD in avgusta kupil kanadsko podjetje Taalas, prav tako usmerjeno v razvoj rešitev za izvajanje. Tovrstnih zagonskih družb je pravzaprav kar nekaj in imajo ponekod zanimive inženirske rešitve. Ameriška SambaNova razvija neke vrste čipe FPGA, ki jim je mogoče hitro preusmeriti tokove podatkov in jih prirediti za različne naloge. A zaradi zgoraj omenjene prevlade programja CUDA ta podjetja večinoma stavijo na to, da jih opazi kateri od velikih igralcev, kot v primeru Groqa, Taalasa ali Annapurne.
Tiha zmagovalca
Razvijanje lastnih rešitev v največjih porabnikih procesorskih vezij gotovo kaže pomemben in zanimiv trend, a v tem trenutku primata Nvidie še ne ogroža. Njeni čipi so še vedno bistveni del najpomembnejšega dogajanja na področju umetne inteligence – razvoja novih modelov, s katerimi morajo podjetja vlagateljem dokazovati, da so vredna denarja in da ima podivjana gradnja podatkovnih centrov smiselno vrednost. Prav tako bi le stežka trdili, da se Google in Amazon tega lotevata zaradi diverzifikacije dobavnih verig. Prav nasprotno, s tem se ozko grlo od Nvidie preprosto premika k naslednjemu, še pomembnejšemu členu: tajvanskemu proizvajalcu TSMC, kjer jim je ob vseh novih bogatih strankah brez dvoma toplo pri srcu. Nobeno od tu opisanih podjetij namreč svojih čipov ne zna izdelovati samo, ker za to potrebujejo najmodernejše proizvodne postopke.
Ne samo to: z izjemo Amazona, ki ima v Annapurni lastni razvojni laboratorij, se vsi opisani akterji pri dizajnu vezij še vedno bistveno naslanjajo na tujo strokovno pomoč, v prvi vrsti Broadcom, ki je poleg TSMC eden manj očitnih zmagovalcev teh trendov. Tudi v Redmondu, kjer na tem področju sodelujejo z Marvellom, naj bi razmišljali o odhodu k Broadcomu. To še zaostri položaj majhnih razvojnih družb in strežniških podjetij, kajti v takšnem tekmovalnem okolju se samo veliki igralci, z dosti pogajalske moči, lahko pririnejo do korita. Zmogljivosti TSMC so pač omejene in zakupljene za dosti časa vnaprej. Da bo mera polna, je videti, da bo dogajanje postalo še živahnejše. Za konec naj namreč omenimo še eno aktualno zanimivost: razmah umetnointeligenčnih agentov je vnovič povečal potrebe po centralnih procesorjih, saj so ti tisti, ki predelujejo ‚želje‘ agentov, kot sta poganjanje zunanjih programov in priprava nalog itd. V AMD so nedavno presodili, da se razmerje v količini CPU in GPU čipov v računskih centrih premika od ena proti šest v lanskem letu nazaj v smeri ena proti ena. Kmalu bo torej vsakdo, ki da kaj nase, moral imeti še lastni CPU.